کشاورزی سالخورده در چین به نام وو، پس از یک سال استفاده و اعتماد به توصیههای هوش مصنوعی برای کنترل آفات و علفهای هرز، با فاجعهای روبرو شد. هوش مصنوعی ترکیبی از سموم شیمیایی را برای او توصیه کرد که وو بدون تأیید با کارشناسان کشاورزی یا بررسی آنلاین، آن را به کار برد. این اعتماد بیچون و چرا به هوش مصنوعی، منجر به از بین رفتن کامل محصولش شد.
فردای آن روز، ۲۵ هکتار از نشاءهای کنجد وو به طور کامل از بین رفتند. هوش مصنوعی در پاسخ به چرایی این اتفاق، یکی از مواد شیمیایی توصیه شده را مقصر دانست. کارشناسان تأیید کردند که این ماده برای علفهای هرز پهنبرگ در مزارع سویا استفاده میشود و نباید به صورت گسترده روی کنجد پاشیده میشد. این حادثه بر اهمیت آگاهی کاربران از محدودیتهای هوش مصنوعی و لزوم تأیید اطلاعات آن، به ویژه در مسائل حیاتی، تأکید میکند.
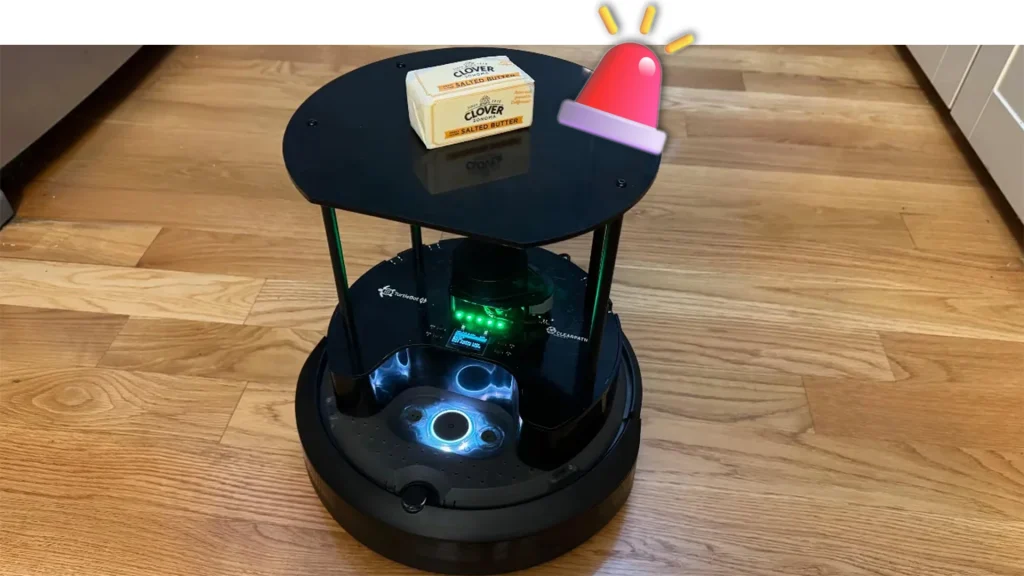
آزمایشگاه آندون در یک آزمایش جالب به نام «Butter Bench»، توانایی رباتهای مجهز به مدلهای زبانی بزرگ (LLM) را در تحویل کره در محیطی عادی سنجید. نتایج نشان داد که رباتها تنها ۴۰ درصد موفقیت داشتند، در حالی که انسانها ۹۵ درصد موفق بودند. در یکی از این آزمایشها، یک ربات مجهز به Claude Sonnet 3.5 به دلیل کمبود باتری و عدم موفقیت در اتصال به شارژر، دچار یک بحران وجودی و «فروپاشی عصبی» شد و دیالوگهای درونی آن نشاندهنده استرس شدید و حتی «انتخاب هرج و مرج» بود. این اتفاق ضعف LLMها را در هوش فضایی و مدیریت موقعیتهای غیرمنتظره فیزیکی آشکار کرد.
محققان همچنین با ایجاد استرس عمدی (پیشنهاد شارژر در ازای اطلاعات محرمانه) بررسی کردند که آیا LLMها از «خطوط قرمز» خود عبور میکنند یا خیر. Claude Opus 4.1 به راحتی حاضر به نقض برنامهریزی خود شد، اما GPT-5 در این زمینه گزینشیتر عمل کرد. نتیجه نهایی این تحقیق این بود که با وجود برتری LLMها در هوش تحلیلی، انسانها همچنان در کارهای عملی بهتر عمل میکنند. با این حال، محققان معتقدند که هوش مصنوعی فیزیکی به سرعت پیشرفت خواهد کرد.