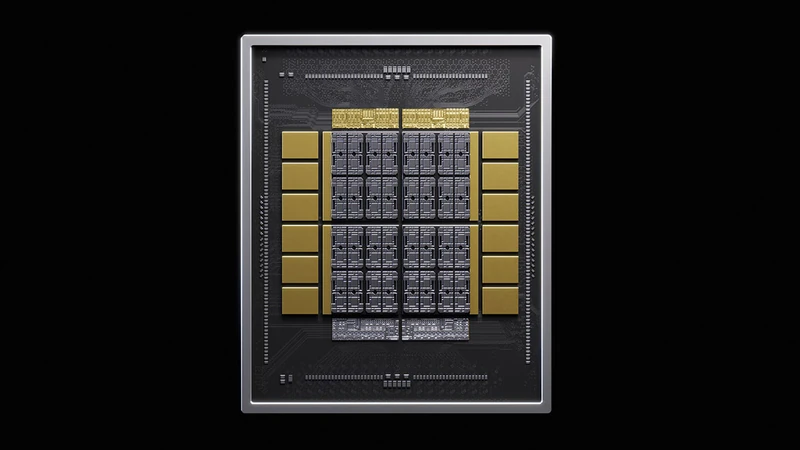
انویدیا NVHBM سفارشی را با پهنای باند و کارایی انرژی بهبود یافته ارائه میدهد
برنامه NVLink Fusion انویدیا، بلوکهای سازندهای را در اختیار شرکای این شرکت قرار میدهد که برای اتصال تراشههای سفارشی به دامنه مقیاسپذیری NVLink استفاده میشوند. این دامنه برای پیوستن چندین پردازنده مجزا به یک سیستم منسجم واحد مانند شتابدهنده مقیاس رک Vera Rubin NVL72 به کار میرود. امروز، انویدیا یک بلوک سازنده جدید به این مجموعه ابزار اضافه میکند: NVHBM، یک پیادهسازی سفارشی از حافظه با پهنای باند بالا که عملاً زیربنای هر شتابدهنده هوش مصنوعی امروزی است.
همانطور که انویدیا توضیح میدهد، NVHBM یک دای پایه HBM سفارشی است که پهنای باند بالاتر، مصرف انرژی کمتر و ردپای کوچکتر روی دای را نسبت به HBM4e سنتی نوید میدهد. انویدیا میگوید که این محصول با همکاری “فروشندگان پیشرو حافظه” طراحی و تأیید شده است، بنابراین به توسعهدهندگان سیلیکون سفارشی، زمان ورود به بازار سریعتری را نسبت به پیادهسازی HBM معمولی از ابتدا ارائه میدهد. اما لازم به تأکید مجدد است که این یک جایگزین HBM نیست. بلکه یک بلوک سازنده جدید است که انویدیا فقط به شرکای سیلیکون سفارشی خود ارائه میدهد.
پهنای باند حافظه برای شتابدهندههای هوش مصنوعی حیاتی است و NVHBM تا 30 درصد پهنای باند بالاتر در هر پشته نسبت به HBM4e استاندارد را نوید میدهد. برای بارهای کاری هوش مصنوعی که محدود به پهنای باند حافظه هستند، این پهنای باند بالاتر به توان عملیاتی بیشتر، مانند نرخ توکن در ثانیه بالاتر برای استنتاج هوش مصنوعی، منجر میشود.
دای پایه سفارشی NVHBM همچنین ردپای مدارهای مرتبط با حافظه را روی دای اصلی شتابدهنده سفارشی کاهش میدهد. به طور سنتی، کنترلکننده حافظه HBM در دای اصلی سیلیکون روی بسته گنجانده میشد. NVHBM به جای آن، کنترلکننده حافظه را به دای پایه پشته HBM منتقل میکند و یک PHY سفارشی کوچکتر ارائه میدهد که مشتریان NVLink Fusion میتوانند آن را در طراحیهای خود ادغام کنند.
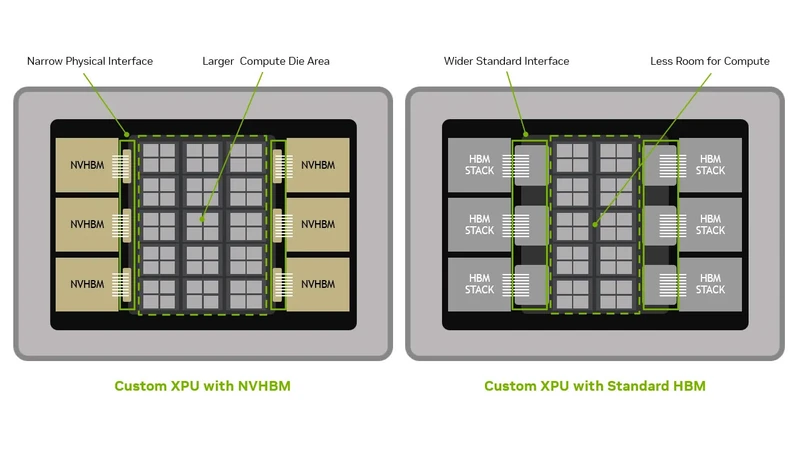
انویدیا میگوید این رویکرد فضای ارزشمند بسته را آزاد میکند که میتواند برای افزایش مساحت دای محاسباتی اضافی استفاده شود — تا 30 درصد محاسبات بیشتر روی دای اصلی سیلیکون. NVHBM همچنین وعده میدهد که مسیریابی اینترپوزر مورد استفاده برای اتصال چندین تراشه به یکدیگر را برای طراحیهایی که از تکنیکهای بستهبندی پیشرفته استفاده میکنند، سادهتر کند.
NVHBM همچنین صرفهجویی در مصرف انرژی را نسبت به پشتههای HBM4e آماده ارائه میدهد. همانطور که انویدیا به طور مداوم در معرفی Vera Rubin تأکید کرده است، هر واتی که صرف تولید توکن نشود، هدر رفته است. انویدیا میگوید NVHBM از 15 درصد انرژی کمتری نسبت به HBM4e معمولی استفاده میکند و این صرفهجویی در انرژی میتواند برای بهبود عملکرد به ازای هر وات، تخصیص مجدد به واحدهای عملکردی بیشتر برای طراحی شتابدهنده سفارشی، یا تبدیل به عملکرد پایدارتر در همان بودجه انرژی استفاده شود.
پهنای باند بالاتر با مصرف انرژی کمتر یک مزیت بزرگ برای شتابدهندههای هوش مصنوعی است که ساختارهای داده عظیم مانند وزن مدلها و کشهای KV را جابجا میکنند، به خصوص زمانی که این صرفهجوییها در هزاران تراشه ضرب شوند. انرژی ذخیره شده در جابجایی دادهها میتواند به عملکرد بالاتر خود شتابدهنده بازگردانده شود یا برای پشتیبانی از تعداد بیشتری از شتابدهندهها در همان پاکت انرژی ثابت تخصیص یابد.
اما اینها، در حال حاضر، دلایلی برای شرکای احتمالی انویدیا هستند تا ادغام NVLink Fusion و NVHBM را در طراحیهای سفارشی خود در نظر بگیرند، نه مزایایی که در سیستمهای مقیاس رک Rubin که از قبل در تولید هستند، محقق خواهند شد.
همراه با خود NVHBM، انویدیا اعلام کرد که آزمایشگاههای Annapurna آمازون اولین شریک آن در NVHBM خواهند بود. و نفیه بشاره، معاون رئیس Annapurna میگوید: “ما مشتاقانه منتظر این همکاری فناوری برای بهرهمندی از طراحیهای زیرساخت آینده AWS هستیم.” تراشههای هوش مصنوعی نسل بعدی Trainium 4 Annapurna از قبل از رابط مقیاسپذیری NVLink Fusion پشتیبانی میکنند، بنابراین به نظر میرسد که تراشههای بعدی نیز از NVHBM پشتیبانی خواهند کرد.
- کولبات
- شهریور 5, 1405
- 29 بازدید