اجرای موفقیتآمیز CUDA روی سختافزار AMD در ویندوز بدون مجازیسازی
با آخرین بهروزرسانیهای ROCm، AMD بالاخره پشتیبانی قوی و رسمی از PyTorch و HIP SDK را برای ویندوز و کارتهای گرافیک مصرفکننده ارائه کرد که بهطور کامل از سری Radeon RX 7000 و RX 9000 پشتیبانی میکند. برای فریمورکهای بومی و پشتیبانیشده، AMD در ویندوز بالاخره به یک واقعیت قابل اجرا تبدیل شده است، اما اگر بخواهید یک برنامه اختصاصی، یک مخزن قدیمی، یا یک ابزار هوش مصنوعی تخصصی را اجرا کنید که مطلقاً از هیچ چیز جز CUDA انویدیا پشتیبانی نمیکند، چه اتفاقی میافتد؟ اینجاست که یک پروژه جدید، یعنی «CUDA-for-AMD-Windows» از Speedstu، میتواند راهگشا باشد. این پروژه ثابت میکند که اجرای بارهای کاری کاملاً انحصاری CUDA بر روی سختافزار AMD در ویندوز بدون مجازیسازی یا بوت دوگانه امکانپذیر است.
برای روشن شدن موضوع، این پروژه یک زمان اجرای کاملاً جدید نیست. در عوض، یک راهاندازی PowerShell بسیار خودکار و قابل بازتولید است که شکاف بین ZLUDA، لایه ترجمه شناختهشده و قبلاً تحت حمایت مالی AMD، و HIP/ROCm SDK بومی AMD برای ویندوز را پر میکند. از طریق مجموعهای از اسکریپتهای هوشمند، این ابزار بهطور خودکار معماری GPU کاربر را شناسایی میکند، یک نسخه خاص از ZLUDA (v6-preview.69) را دریافت میکند و، حداقل در تئوری، آن را بهطور یکپارچه به کتابخانههای ریاضی ROCm که از قبل در ویندوز موجود هستند، نگاشت میکند.
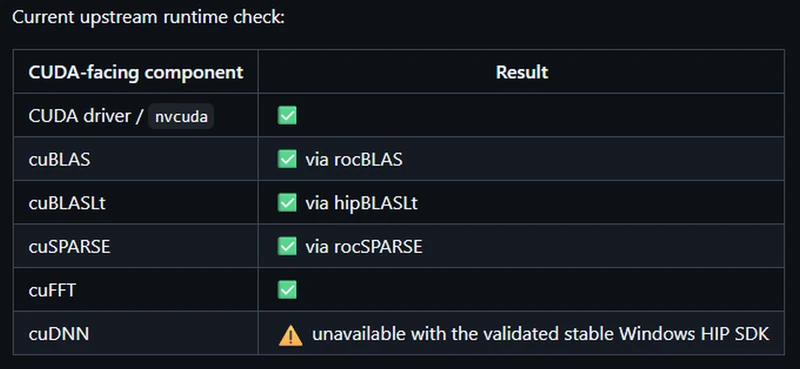
نتیجه این است که توسعهدهنده با موفقیت API درایور CUDA و همچنین کتابخانههای cuBLAS، cuSPARSE و cuFFT را مستقیماً به معادلهای AMD آنها رهگیری و نگاشت کرده است. بهعنوان اثبات مفهوم، نویسنده حتی یک شبکه یادگیری تقویتی PPO با ۲.۲ میلیون پارامتر را بهطور کامل با استفاده از کتابخانههای CUDA بدون تغییر بر روی یک AMD Radeon RX 9060 XT آموزش داد که در حال حاضر تنها GPU پشتیبانیشده رسمی است.
حتی با وجود پشتیبانی رسمی ROCm از AMD در ویندوز، جامعه توسعهدهندگان محلی اغلب هنگام امتحان کردن مخازن آزمایشی GitHub یا ابزارهای هوش مصنوعی تخصصی که CUDA را بهعنوان یک الزام کدگذاری کردهاند، با مشکلات وابستگی مواجه میشوند. برای توسعهدهندگانی که میخواهند با این ابزارهای فقط CUDA بهصورت بومی بر روی ماشینهای ویندوز روزمره خود آزمایش کنند، بدون اینکه با مشکلات عبور WSL2 دست و پنجه نرم کنند یا منتظر بمانند تا نویسنده اصلی یک پورت HIP بنویسد، این پروژه یک خط لوله ترجمه بسیار مطلوب را ارائه میدهد. این پروژه بهعنوان نوعی آداپتور موقت برای نرمافزارهایی عمل میکند که سرسختانه کارت NVIDIA را طلب میکنند.
آزمایشهای بنچمارک موجود در مستندات پروژه یافتههای جالبی را ارائه میدهد. در یک آزمایش کنترلشده A/B که یک بار کاری یادگیری تقویتی ۲.۲ میلیون پارامتری را بر روی Radeon RX 9060 XT اجرا میکرد، «مسیر بالادستی عمومی» که صرفاً بر نسخههای رسمی ZLUDA و HIP SDK 6.4 استاندارد AMD متکی است، به توان عملیاتی متوسط ۱۳,۲۷۸ گام در ثانیه (SPS) دست یافت. در مقابل، یک «پوشش سفارشی بازیابیشده» اختیاری که ظاهراً از باینریهای قدیمی ZLUDA ساخته شده بود، کمی بدتر عمل کرد و به ۱۲,۸۷۶ SPS رسید که تقریباً ۳٪ کندتر است. در حالی که راهاندازی رسمی و تمیز سریعتر است، نویسنده اشاره میکند که «بازنویسی بعدی LibTorch/ZLUDA را از PPO حذف کرد و به توان عملیاتی بهطور قابل توجهی بالاتری دست یافت»، که نشان میدهد هنوز هم برای این پشته از مترجمها افت عملکرد وجود دارد.
اکنون، قبل از اینکه کسی اعلام کند که انحصار CUDA رسماً از بین رفته است، تعیین انتظارات واقعبینانه بسیار مهم است. اولاً، این یک پروژه متنباز انفرادی است، نه یک راهحل در سطح سازمانی. نویسنده در مورد دامنه محدود آن بسیار شفاف است، زیرا کتابخانههای حیاتی یادگیری ماشین مانند cuDNN، TensorRT و NCCL هنوز پشتیبانی نمیشوند. این بدان معناست که سازگاری کاملاً به بار کاری بستگی دارد؛ اگر ابزار هوش مصنوعی خاص شما به شدت به cuDNN متکی باشد، این راهاندازی با شکست مواجه خواهد شد. علاوه بر این، لازم به ذکر است که ZLUDA خود در حال حاضر پس از از دست دادن حمایت تجاری خود برای بار دوم، بهعنوان یک «پروژه سرگرمی آخر هفته» نگهداری میشود. اتکا به این خط لوله برای کارهای در سطح تولید، یک ریسک بزرگ باقی میماند. این مخزن ابزاری برای علاقهمندان است، نه یک استراتژی استقرار IT شرکتی.
با وجود این محدودیتها، «CUDA-for-AMD-Windows» بسیار هیجانانگیز است، زیرا ثابت میکند که مانع اجرای نرمافزارهای انحصاری CUDA بر روی GPUهای AMD، یک نقص سختافزاری غیرقابل حل نیست، بلکه یک مشکل ابزار ترجمه نسبتاً قابل مدیریت است. از آنجایی که این پروژه کاملاً متنباز است، پتانسیل آن بسیار فراتر میرود از این اثبات مفهوم اولیه. با مشارکتهای جامعه، میتوانیم شاهد تشخیص سختافزاری گستردهتر و پچهای هوشمندانه برای حل صحیحتر کتابخانههای CUDA سرسختتر باشیم.
- کولبات
- شهریور 23, 1405
- 12 بازدید